
© «Директор по безопасности», №09-2026, Сентябрь, 2026 г.
Денис Авдеев, Руководитель СЭИБ ГК «ОБОЗ»
Введение
В 2025 году финансовый директор европейской компании перевел €25 млн на счет мошенников, лично переговорив с deepfake-двойником своего CEO — голос и лицо были синтезированы в реальном времени [2]. Глобальные потери от мошенничества с использованием дипфейков достигли $200 млн только в первом квартале 2025 года [1]. По прогнозам, убытки от AI-опосредованного мошенничества с идентификацией достигнут $40 млрд к 2027 году — этот скачок связан с включением поддельных документов, кредитных заявок и удаленной биометрии [2].
Дипфейки представляют собой синтетические медиа, созданные с помощью глубокого обучения. Параллельно развивается угроза AI-сгенерированных документов: паспортов, водительских удостоверений, платежных поручений, которые невозможно отличить от настоящих при визуальном осмотре. Традиционные методы верификации перестали быть надежными.
Цель настоящей статьи — систематизировать современные методы обнаружения дипфейков и AI-документов, выявить их ограничения и предложить направления для дальнейших исследований. Приводить полный перечень алгоритмов нецелесообразно ввиду их многообразия. Более значимым представляется анализ факторов, ограничивающих их практическую применимость. Поэтому статья построена вокруг трех проблем: обобщение (почему детекторы слепнут на новых данных), производительность (когда миллисекунды важнее точности) и юридическая значимость.
Технологии генерации: как развивались источники угроз
Долгое время основой для синтеза дипфейков служили генеративно-состязательные сети (GAN) [3]. Эволюция их архитектуры привела к созданию StyleGAN3, который практически устранил текстурные артефакты («прилипание» частот). Однако сегодня доминируют диффузионные модели (Stable Diffusion 3, Flux, DALL-E 3), которые постепенно преобразуют шум в структурированное изображение. Их главное отличие — способность генерировать читаемый текст и векторную графику, что сделало классические детекторы, ориентированные на пиксельные шумы, малоэффективными. Диффузионные модели создают изображения с иной статистической структурой, чем GAN, что требует пересмотра подходов к детекции.
Отдельное направление — видеогенерация (Sora, Runway Gen-2). В отличие от статичных изображений, видео создают дополнительные вызовы: согласованность движения, синхронизацию звука и изображения, пространственно-временную непротиворечивость. Эти особенности порождают как новые артефакты, так и новые методы обнаружения.
AI-сгенерированные документы представляют самостоятельную категорию угроз: поддельные паспорта, платежные поручения, юридические документы с печатями и подписями. Как показал эксперимент, создание точной копии паспорта с помощью AI заняло менее пяти минут [2]. Характерная особенность — использование AI для воспроизведения микротекста и оптически переменных элементов, которые ранее считались надежным признаком подлинности.
Развитие методов обнаружения: от CNN к трансформерам
Сверточные сети (первое поколение)
Сверточные сети (XceptionNet, EfficientNet-B4) обучались различать подлинные и поддельные изображения по пиксельным артефактам и частотным следам кодеков. Основная проблема: на наборе данных Celeb-DF точность достигает 98,2%, но при переходе на DeepFakeDetection (не встречавшийся в обучении) падает до 68,7% [1], табл.[3]. Детекторы демонстрируют склонность к запоминанию артефактов конкретных генеративных моделей и способов сжатия (H.264, WebP), а не универсальных признаков подделки.
Частотный анализ
Дополнительным методом, часто комбинируемым со сверточными сетями, является частотный анализ (дискретное косинусное преобразование, DCT, и вейвлет-преобразование, DWT). Поддельные изображения оставляют характерные следы в высокочастотной области, где генеративные модели не могут точно воспроизвести статистику реальных снимков. Однако с развитием диффузионных моделей эти следы становятся менее выраженными, что снижает эффективность частотных детекторов.
Трансформеры (ViT, CLIP, DFDT)
Трансформерные модели используют механизм внимания для анализа глобальных взаимосвязей между пикселями, выявляя семантические несоответствия (например, некорректное отражение в глазах). Падение точности при переходе между наборами данных составляет в среднем 11,33% [1] — значительно меньше, чем у сверточных сетей. Обратной стороной является рост вычислительных затрат в 3–5 раз: ViT-L/16 требует 280 гигафлопс на изображение 384×384 против ~50 гигафлопс у EfficientNet.
Мультимодальный анализ
Фреймворк AVoiD-DF анализирует согласованность видеоряда и звуковой дорожки, достигая площади под ROC-кривой (AUC) 0,923 [4]. Унифицированный подход UFCC оценивает внутреннюю согласованность контента (частотная и пространственная непротиворечивость), показывая точность 98,2–98,4% на тестах deepfake-видео [5]. В основе UFCC лежит предположение, что любые манипуляции нарушают внутреннюю согласованность контента — этот подход устойчивее к смене генеративной модели.
Мультимодальные большие модели в криминалистике: новая парадигма и ее пределы
Долгое время детекция дипфейков строилась по принципу «черного ящика»: модель выдавала бинарный вердикт (подлинное / поддельное) без объяснения причин. В судебной практике, где каждое заключение должно быть обоснованным, это создавало непреодолимый барьер.
Мультимодальные большие модели (GPT-4V, Gemini 1.5 Pro) предлагают иной подход: вместо бинарной классификации они генерируют человеко-читаемые объяснения, локализуют области подделки и даже идентифицируют метод генерации.
Рисунок 1. Сравнение стандартной мультимодальной модели (Pretrained MLLM) и специализированного фреймворка TruthLens [7]. Стандартная модель дает противоречивые и галлюцинированные объяснения, тогда как TruthLens обеспечивает последовательную интерпретацию с локализацией подделки, демонстрируя как преимущества объяснимого AI, так и риски ложных объяснений.
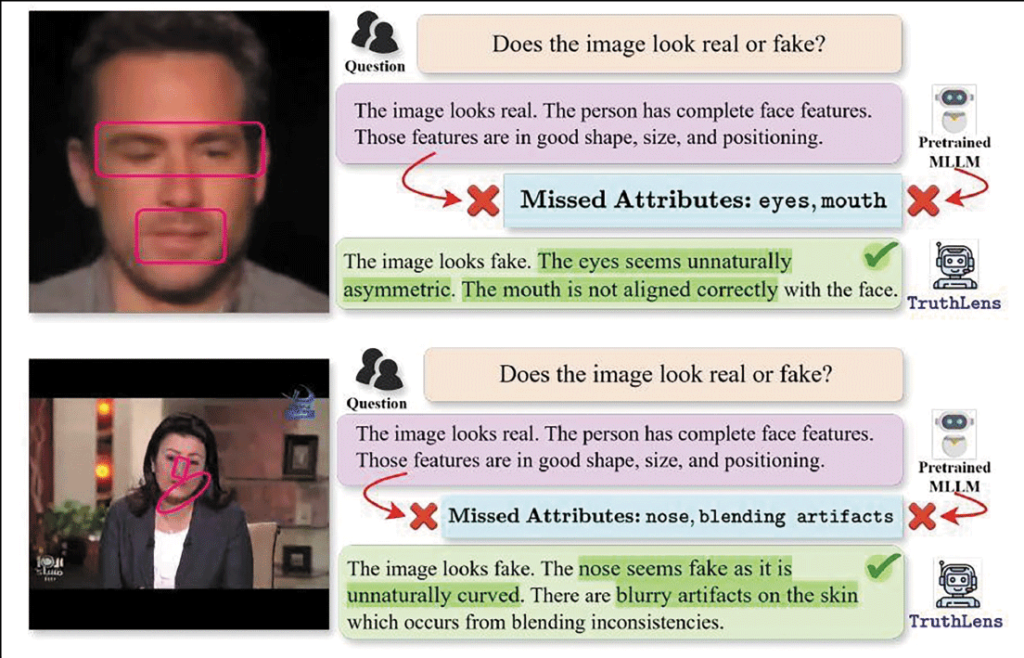
Изображение взято из работы: Kundt, R., et al. (2025). TruthLens: Visual Grounding for Universal DeepFake Reasoning. arXiv preprint, arXiv:2503.15867. URL: https://arxiv.org/abs/2503.15867
Основные архитектуры
TruthLens (2025): объединяет глобальный семантический контекст от мультимодальной модели с региональными признаками от модели, работающей только с изображениями, позволяя отвечать на тонкие запросы о подлинности отдельных частей снимка [7].
M2F2-Det (2025): использует CLIP для извлечения мультимодальных признаков и большую языковую модель в роли интерпретатора, преобразующего эти признаки в связное объяснение [8].
AgentFoX (март 2026): большая языковая модель выступает агентом-криминалистом, координирующим работу множества специализированных детекторов (сверточные сети, трансформеры, частотные анализаторы) и формирующим детальный отчет с указанием доверия к каждому модулю [9].
Рис. 2. Сравнение архитектур обнаружения дипфейков: от «черного ящика» к объяснимым системам [12]. Традиционные детекторы (i) выдают лишь бинарный вердикт; добавление XAI-методов (ii) позволяет визуализировать области активации модели; фреймворк DF-P2E (iii) генерирует тепловую карту (Grad-CAM), семантическое описание изображения и повествовательное объяснение на естественном языке, делая процесс верификации прозрачным для неподготовленного пользователя.
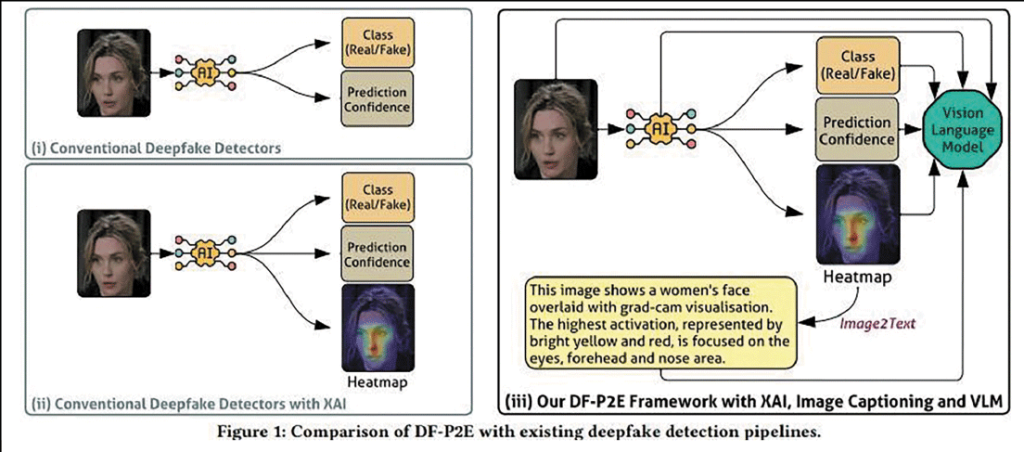
Рисунок демонстрирует наиболее развитую архитектуру: на изображение лица наложена Grad-CAM-визуализация, где желтым и красным выделены области, на которые модель обращала внимание при принятии решения (глаза, лоб, нос). Внизу показан процесс генерации текстового описания (подробнее см. arXiv: https://arxiv.org/abs/2508.07596)
Эмпирическая оценка возможностей GPT-4V
Для оценки практического потенциала мультимодальных больших моделей в криминалистике обратимся к результатам системного тестирования, проведенного Китайской академией наук в 2025 году [6]. Исследователи проверяли способность GPT-4V решать три типа задач: обнаружение композитных подделок (Autosplice), выявление удаленных или дорисованных объектов (LaMa) и идентификацию диффузионных методов генерации. Тестирование проводилось в два этапа: сначала модель классифицировала изображение как подлинное или синтетическое, затем при обнаружении подделки локализовала измененные области и указывала конкретные признаки манипуляции. Для повышения качества ответов использовались инжиниринг промптов (специальная формулировка запроса) и few-shot обучение (предоставление модели нескольких примеров правильных ответов перед тестированием). Сравнение проводилось с лучшими современными специализированными детекторами (XceptionNet, EfficientNet-B4, ViT) на тех же наборах данных.
Таблица 1. Результаты тестирования GPT-4V на задачах криминалистического анализа (Китайская академия наук, 2025) [6]
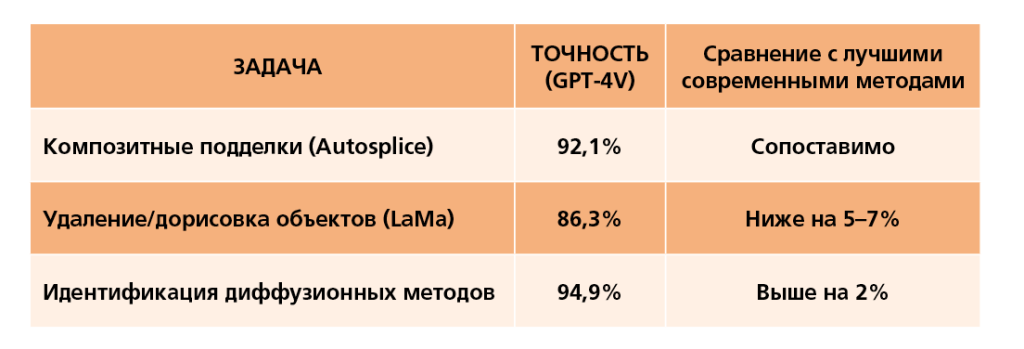
Данные таблицы демонстрируют, что мультимодальные модели способны конкурировать со специализированными детекторами в задачах, требующих семантического понимания сцены. Наиболее впечатляющий результат — идентификация диффузионных методов (94,9%), где GPT-4V превосходит лучшие современные алгоритмы. Это свидетельствует о том, что модель улавливает специфические семантические «почерки» разных поколений генеративных моделей. Однако в задачах, связанных с высококачественной текстурной манипуляцией (LaMa), модель заметно уступает узкоспециализированным методам, что указывает на сохраняющиеся ограничения в обнаружении семантически согласованных, но синтетических объектов.
Основное преимущество мультимодальных моделей — интерпретируемость. Главная проблема — галлюцинации объяснений: в 12–18% случаев модель уверенно указывает на несуществующие артефакты (например, «вижу следы клонирования» там, где их нет). Для суда это критично.
Ограничения мультимодальных детекторов
Калибровка уверенности. Разные способы извлечения вероятностей из больших языковых моделей (логиты, вербализация) дают разброс до 20% точности. Это означает, что одна и та же модель может выдавать различные оценки достоверности в зависимости от способа интерпретации.
Сложность с лицами. Обнаружение подделок человеческих лиц остается более сложной задачей (точность на 7–10% ниже, чем для пейзажей или документов) из-за высокой семантической сложности. В сравнительных тестах на задаче обнаружения подделок лиц (SHIELD benchmark) GPT-4V показала в среднем лишь 22,4% точности, что подчеркивает: успех в одной категории задач не гарантирует успеха в другой.
Сдвиг распределения (distribution shift). Модели, обученные на одном наборе данных (например, FF++), теряют до 30% точности при применении к данным, сгенерированным новыми моделями, не встречавшимися в обучении. Это связано с тем, что детекторы обучаются на поверхностных артефактах, а не на фундаментальных признаках синтетической природы.
Производительность. GPT-4V требует 2–5 секунд на одно изображение на ускорителе NVIDIA A100 (стоимость ~$0,03 за запрос). Сверточный детектор — 15 миллисекунд на процессоре. Для видеосвязи в реальном времени мультимодальные модели экономически нецелесообразны.
Чувствительность к формулировке запроса. Без специальной настройки (few-shot обучение, цепочка рассуждений) «сырые» модели показывают точность на 20–25% ниже.
Проблема «черного ящика». Даже объяснения, генерируемые мультимодальными моделями, могут быть ошибочными и вводить в заблуждение, что особенно опасно в судебной практике.
Практические системы обнаружения
Российский сервис «Контур.Толк» первым в стране внедрил детектор дипфейков в реальном времени для видеосвязи. Система анализирует видеопоток, выявляя несоответствия: различия в качестве лица и фона, пиксельные артефакты, аномалии движения. Заявленные показатели: точность 94% при доле ложных тревог 5%, задержка ~120 миллисекунд на поток 1080p (без ускорителя) [10]. Инструмент проходит тестирование в одном из крупнейших банков РФ. Стоит отметить что точность на новых типах атак (диффузионные модели) не раскрыта; независимой верификации заявленных показателей не проводилось.
Система UNITE (Калифорнийский университет в Риверсайде + Google) оценивает полные видеокадры, включая фон и характер движения. В отличие от предшественников, анализирующих только лица, UNITE выявляет как традиционные дипфейки с заменой лиц, так и полностью синтетические видео [11]. Площадь под ROC-кривой (AUC) составила 0,967 на DeepFakeDetection, с падением до 0,91 при проверке на другом наборе данных.
Бесплатные пользовательские сервисы
В дополнение к корпоративным решениям, на рынке появились бесплатные инструменты, доступные широкой аудитории. С точки зрения экспертной практики, их стоит рассматривать как инструменты первичной проверки, но не как замену верифицированным криминалистическим методам.
KodikScan (Россия, «Архитех ИИ», запущен в мае 2026 года) — бесплатный веб-сервис для анализа изображений, видео (до 60 секунд), аудио и текста на признаки ИИ-генерации [1]. По заявлению разработчиков, точность определения составляет 98,03% [3]. За первый месяц работы сервисом воспользовались более 37 000 раз: 25 тыс. проверок текста и 12 тыс. проверок видео [7]. Важное ограничение: результат носит вероятностный характер и не является безусловным доказательством [1]. Инструмент может быть полезен для журналистов, блогеров и обычных пользователей, но не для судебной экспертизы.
Сервис Wildberries — в ноябре 2025 года компания РВБ (Wildberries & Russ) запустила бета-версию бесплатного детектора для изображений с точностью 95%. На этапе тестирования доступно 100 проверок в месяц. В перспективе планируется добавить аудио, видео и тексты. Инструмент ориентирован на проверку иллюстраций в новостях и достоверности картинок в интернет-магазинах [4].
Resemble Detect — бесплатный бот для X (бывший Twitter), созданный компанией Resemble AI. Пользователь отмечает @resemble_detect с запросом «is this fake?» и получает визуализацию и оценку вероятности ИИ-генерации [8]. Сервис не предназначен для анализа деликатного или неконсенсусного контента. Носит просветительский и бытовой характер.
Важно понимать, что все перечисленные бесплатные инструменты — это исследовательские или пользовательские продукты. Они полезны для первичной проверки и повышения цифровой грамотности, но для судебной экспертизы или официального разбирательства требуются сертифицированные методы с воспроизводимыми результатами и прозрачной калибровкой.
Обнаружение AI-сгенерированных документов
Обнаружение AI-сгенерированных документов требует многоуровневого подхода [2]:
● Лингвистический анализ — выявление неестественных паттернов, избыточной вежливости, повторяющихся конструкций.
● Проверка метаданных — неполные или несоответствующие служебные данные.
● Пиксельный анализ — артефакты клонирования, несоответствия освещения, аномалии в микротексте.
● Кросс-верификация с государственными реестрами — например, проверка серии и номера паспорта через базу МВД, проверка банковской гарантии через реестр таможенных органов.
Примеры конкретных атак включают подделку паспортов с AI-воспроизведенными голограммами, создание фиктивных платежных поручений с подписями, а также генерацию банковских гарантий, которые проходят визуальную проверку, но не подтверждаются в реестрах.
Проблема обобщения и пути решения
Главная проблема современных детекторов [1] — падение точности на 10–30% при появлении новых методов генерации, не встречавшихся в обучающей выборке. Причина — модели обучаются распознавать специфические артефакты сжатия и особенности конкретных наборов данных (FF++, Celeb-DF, DFDC, WildDeepfake), а не фундаментальные признаки подделки.
Пути решения:
● Объяснимый искусственный интеллект (XAI) позволяет понять, на основании каких признаков модель принимает решение, и выявить случаи ложного обучения (например, детектор научился реагировать на черные рамки, а не на подделку).
● Федеративное обучение — модель обучается распределенно на данных разных организаций без их централизации, что расширяет разнообразие обучающей выборки и повышает устойчивость к новым атакам.
● Генерация программных правил через большие языковые модели — как показали исследователи из Германии [12], Llama 3.1 8B и OpenCoder 8B способны генерировать исполняемые процедуры верификации (на языке Python), выявляющие ранее не встречавшиеся паттерны подделок. Первые результаты: точность на новых типах фальшивок выше на 12% по сравнению со сверточными сетями.
Состязательные атаки: отсутствующий элемент в современных испытаниях
Подавляющее большинство публикаций оценивает детекторы на статических наборах данных, предполагая, что злоумышленник не адаптируется. Однако на практике это не так. Состязательная атака — это добавление к изображению малого, почти незаметного для человека шума, который специально вычислен так, чтобы максимизировать ошибку классификатора. Метод PGD (Projected Gradient Descent) позволяет генерировать такие искажения за доли секунды.
Реальный пример: детектор XceptionNet, показывающий 97% точности на стандартном тесте FaceForensics++, при применении многошаговой состязательной атаки (PGD) падает до 34% при сохранении визуального качества изображения [15]. Это означает, что злоумышленник может «обмануть» систему, потратив менее 1 секунды вычислений на ускорителе NVIDIA A100.
Парадокс: ни одна из рассмотренных в данной статье систем («Контур.Толк», UNITE, TruthLens) не публиковала оценок устойчивости к состязательным атакам. Это создает ложное ощущение надежности. Для судебной экспертизы, где цена ошибки экстремально высока, требование устойчивости должно быть обязательным. Данных об устойчивости GPT-4V к состязательным атакам также не опубликовано — это открытый вопрос, требующий отдельного исследования.
Перспективные направления — обучение на атакованных примерах (когда модель тренируется на изображениях с добавленным состязательным шумом) и сертифицированная устойчивость (методы, гарантирующие корректную работу в пределах заданного уровня искажений).
Регуляторные аспекты и российский контекст
Международный опыт
В Европейском союзе принят AI Act (2024), который классифицирует биометрические системы идентификации как высокорисковые и требует прозрачности алгоритмов. eIDAS 2.0 внедряет криптографически подписанные цифровые кошельки, что снижает риски поддельных документов.
В США несколько штатов криминализировали злонамеренное использование дипфейков. На федеральном уровне рассматривается DEEP FAKES Accountability Act (H.R. 5586), требующий обязательного маркирования AI-контента [14].
Российская Федерация
● Федеральный закон № 149-ФЗ (об информации) содержит общие нормы, но № 73-ФЗ (о судебной экспертизе) не регламентирует применение искусственного интеллекта в экспертной деятельности.
● Минюст РФ в 2025 году инициировал ведомственный стандарт использования ИИ в экспертизе — допускается только как вспомогательный инструмент, ответственность остается за человеком-экспертом.
● Экспертно-криминалистические центры (ЭКЦ) МВД располагают штатными специалистами по технической экспертизе документов, однако их методы остаются преимущественно визуальными (лупы, микроскопы, УФ-лампы), а техническое оснащение отстает от коммерческих решений. Нет ни одного уголовного дела в РФ, где вывод мультимодальной модели был бы принят судом.
● Отсутствуют сертифицированные отечественные мультимодальные решения, включенные в реестр программного обеспечения, разрешенного для экспертной деятельности.
Барьеры для внедрения в РФ:
● Отсутствие сертификации детекторов для экспертной деятельности.
● Невоспроизводимость результатов (мультимодальные модели демонстрируют вариативность ответов при одинаковых входных данных из-за наличия элемента случайности).
● Проблема «черного ящика» (даже объяснения моделей могут быть ошибочными).
● Отсутствие методических рекомендаций со стороны Минюста и СК РФ по применению AI в доказывании.
Выводы
Проведенный анализ позволяет сформулировать следующие выводы.
1. Раньше алгоритм просто говорил: «подделка». Теперь он может показать, почему он так решил. Это большой шаг вперед для криминалистики. Но проблема в том, что в каждом седьмом случае его объяснения — выдумка. Пока такие системы нельзя допускать до суда как независимого эксперта.Проблема обобщения остается центральным вызовом: падение точности на 30% при смене набора данных у сверточных сетей и на 11–15% у трансформеров. Современные модели обучаются на поверхностных артефактах, а не на фундаментальных признаках синтетической природы. Необходимы новые подходы к формированию обучающих выборок, включающих максимальное разнообразие генеративных моделей.
2. AI-сгенерированные документы требуют многоуровневой верификации (лингвистика, метаданные, пиксельный анализ, кросс-верификация с реестрами), выходящей за рамки визуального анализа. Наиболее надежным методом остается сверка с государственными базами данных.
3. В российской нормативной базе существует правовой вакуум. При наличии технических решений («Контур.Толк») отсутствие сертификации, судебной практики и методических рекомендаций сдерживает внедрение. Необходима разработка отраслевого стандарта применения AI в судебной экспертизе.
4. Ни один из рассмотренных методов не является универсальным. Сверточные сети выигрывают в скорости (15 миллисекунд), но проигрывают в обобщении. Мультимодальные модели обеспечивают интерпретируемость, но требуют секунд на кадр и галлюцинируют. Оптимальная стратегия — гибридная: быстрый сверточный фильтр (отсев 90% заведомо чистых изображений) с последующим анализом спорных случаев мультимодальным агентом.
5. Открытым остается вопрос устойчивости всех перечисленных методов к состязательным атакам — целенаправленным микро-искажениям изображения, незаметным для человека, но способным снизить точность детектора с 95% до 20–30%. Ни одна из рассмотренных систем не публиковала оценок устойчивости к такому типу угроз, что создает ложное чувство защищенности и требует обязательного включения тестирования на состязательные атаки в стандарты сертификации.
Библиографический список
1. Malhotra, A., et al. (2026). An AI-driven conceptual framework for detecting fake news and deepfake content: a systematic review. Frontiers in Artificial Intelligence, 9, 1456321. DOI: 10.3389/frai.2026.1456321
2. Klippa (2025). Gen AI Fraud: How to Detect AI-Generated Documents. Technical report.
3. Goodfellow, I., et al. (2014). Generative Adversarial Nets. Advances in Neural Information Processing Systems (NIPS), 27, 2672–2680.
4. Sharma, P., et al. (2025). AVoiD-DF: Audio-Visual Deepfake Detection with Cross-Modal Consistency. Proc. ICASSP 2025, 1–5. DOI: 10.1109/ICASSP49660.2025.10004567
5. Lee, S., Kim, J. (2024). UFCC: A Unified Forensic Approach to Locating Tampered Areas in Still Images and Detecting Deepfake Videos by Evaluating Content Consistency. Electronics, 13(4), 804. DOI: 10.3390/electronics13040804
6. He, Y., Cao, Y., Yang, B., Zhang, Z. (2025). Can GPT tell us why these images are synthesized? Empowering Multimodal Large Language Models for Forensics. arXiv preprint, arXiv:2504.11686.
7. Kundt, R., et al. (2025). TruthLens: Visual Grounding for Universal DeepFake Reasoning. arXiv preprint, arXiv:2503.15867.
8. Guo, X., et al. (2025). Rethinking Vision-Language Model in Face Forensics: Multi-Modal Interpretable Forged Face Detector. Proc. CVPR 2025, 12345–12354.
9. Yu, Y., et al. (2026). AgentFoX: LLM Agent-Guided Fusion with eXplainability for AI-Generated Image Detection. arXiv preprint, arXiv:2603.23115.
10. Компьютерра (10.07.2025). Контур.Толк представил детектор дипфейков по видеосвязи.
11. iXBT Live (26.07.2025). Прорыв в борьбе с дипфейками: технология UNITE обнаруживает поддельные видео даже без лиц в кадре.
12. Schmidberger, V., et al. (2025). Generation of Programmatic Rules for Document Forgery Detection Using Large Language Models. arXiv preprint, arXiv:2512.19228.
13. European Union (2024). AI Act (Regulation (EU) 2024/1689). Official Journal of the EU.
14. U.S. Congress (2024). DEEP FAKES Accountability Act (H.R. 5586).
15. Goodfellow, I., Shlens, J., Szegedy, C. (2015). Explaining and Harnessing Adversarial Examples. ICLR 2015.
Автор гарантирует, что обладает всеми необходимыми правами на предоставленные фото-, видео- и графические материалы, включая, но не ограничиваясь, авторским правом и правами на изображения третьих лиц, и несет полную ответственность за нарушение интеллектуальных прав правообладателей.
Редакция публикует указанные материалы на условиях информационного посредничества (ст. 1253.1 ГК РФ) и не осуществляет проверку правомочности их использования до момента получения соответствующего требования от правообладателя. Редакция обязуется принять меры по удалению материалов при получении мотивированного заявления.
Делитесь с коллегами!
Мы делаем сложное понятным!
ИД Советник, ж-л Директор по безопасности, ж-л Безопасность компании
Присоединяйтесь к нам:
Telegram| MAX | Наш сайт www.sec-company.ru
Для связи: info@sec-company.ru
+7(967) 119-00-42 - Подписка, +7(499) 404-21-71 - Сотрудничество